1. Database Design là gì?
Database Design là quá trình xác định cách tổ chức, lưu trữ và quản lý dữ liệu trong một hệ thống sao cho hợp lý, dễ truy vấn và thuận tiện khi mở rộng. Đây là một bước quan trọng khi xây dựng website, ứng dụng di động hoặc các hệ thống backend.
Khi thiết kế cơ sở dữ liệu, lập trình viên cần xác định hệ thống có những loại dữ liệu nào, mỗi loại dữ liệu gồm những thông tin gì, dữ liệu được lưu trong bảng nào và các bảng liên kết với nhau ra sao.
Ví dụ, đối với một website bán hàng, cơ sở dữ liệu có thể bao gồm các bảng user để lưu thông tin người dùng, product để lưu sản phẩm, oeders để lưu đơn hàng và order_item để lưu chi tiết từng sản phẩm trong đơn hàng.
Nếu thiết kế không hợp lý, dữ liệu có thể bị trùng lặp, khó cập nhật hoặc phát sinh sai lệch khi hệ thống hoạt động. Ngược lại, một cơ sở dữ liệu được thiết kế tốt sẽ giúp việc truy vấn, bảo trì và phát triển thêm chức năng trở nên dễ dàng hơn.
2. Table, Column, Primary Key và Foreign Key
Trong cơ sở dữ liệu quan hệ, dữ liệu thường được tổ chức thành các bảng (table). Mỗi bảng chứa những cột (column) đại diện cho các thuộc tính và những hàng (row) đại diện cho từng bản ghi.
Ví dụ, bảng users có thể chứa các thông tin như ID, họ tên, email và ngày tạo tài khoản. Mỗi người dùng được lưu thành một bản ghi riêng.
Khi thiết kế bảng, có hai khái niệm quan trọng là Primary Key và Foreign Key.
Primary Key là cột hoặc nhóm cột dùng để xác định duy nhất mỗi bản ghi trong bảng. Ví dụ, user_id có thể được sử dụng làm khóa chính của bảng người dùng. Khóa chính không được trùng nhau và không được có giá trị NULL.
Foreign Key là cột hoặc nhóm cột dùng để tạo mối liên kết với khóa chính hoặc một khóa duy nhất phù hợp ở bảng khác. Ví dụ, cột user_id trong bảng orders có thể tham chiếu đến id của bảng users, qua đó xác định đơn hàng thuộc về người dùng nào.
Việc sử dụng khóa chính và khóa ngoại giúp dữ liệu được liên kết rõ ràng, hạn chế những bản ghi tham chiếu đến dữ liệu không tồn tại và duy trì tính toàn vẹn của cơ sở dữ liệu.
3. Database Relationships là gì?
Database Relationships là mối quan hệ giữa các bảng trong cơ sở dữ liệu. Các mối quan hệ này thể hiện cách dữ liệu ở bảng này liên quan đến dữ liệu ở bảng khác.
Trong một ứng dụng thực tế, dữ liệu thường không được lưu toàn bộ trong một bảng duy nhất mà được chia thành nhiều bảng theo từng đối tượng hoặc nghiệp vụ. Relationships giúp kết nối các bảng đó để hệ thống có thể truy vấn thông tin liên quan khi cần thiết.
Ví dụ, trong website bán hàng, một người dùng có thể tạo nhiều đơn hàng. Mỗi đơn hàng thuộc về một người dùng cụ thể. Nhờ mối quan hệ giữa bảng users và bảng orders, hệ thống có thể tìm tất cả đơn hàng của một người dùng mà không cần lặp lại toàn bộ thông tin người dùng trong từng đơn hàng.
Ba loại quan hệ thường gặp nhất là One-to-One, One-to-Many và Many-to-Many.
4. One-to-One, One-to-Many và Many-to-Many
One-to-One (1:1) là quan hệ một-một, trong đó mỗi bản ghi ở bảng này liên kết với tối đa một bản ghi ở bảng kia, và ngược lại. Ví dụ, mỗi tài khoản có thể có một bản ghi cài đặt riêng. Mối quan hệ này thường được triển khai bằng khóa ngoại kết hợp với ràng buộc UNIQUE để tránh nhiều bản ghi cùng tham chiếu đến một đối tượng khi không được phép.
One-to-Many (1) là quan hệ một-nhiều, trong đó một bản ghi ở bảng này có thể liên kết với nhiều bản ghi ở bảng kia, nhưng mỗi bản ghi ở bảng bên kia chỉ thuộc về một bản ghi tương ứng. Ví dụ, một người dùng có thể có nhiều đơn hàng, nhưng mỗi đơn hàng chỉ thuộc về một người dùng. Với quan hệ này, khóa ngoại thường được đặt ở bảng phía nhiều, chẳng hạn user_id trong bảng orders.
Many-to-Many (N) là quan hệ nhiều-nhiều, trong đó nhiều bản ghi ở bảng này có thể liên kết với nhiều bản ghi ở bảng kia. Ví dụ, một sinh viên có thể đăng ký nhiều môn học và mỗi môn học có thể có nhiều sinh viên. Quan hệ này thường được triển khai thông qua một bảng trung gian, chẳng hạn student_courses, chứa khóa ngoại tham chiếu đến bảng sinh viên và bảng môn học.
Việc xác định đúng loại quan hệ ngay từ đầu giúp cơ sở dữ liệu phản ánh chính xác nghiệp vụ và tránh những vấn đề khi truy vấn hoặc cập nhật dữ liệu.
5. Ví dụ thiết kế quan hệ trong website bán hàng
Để hiểu rõ hơn, có thể lấy ví dụ về một website bán hàng với các bảng users, orders, products và order_items.
- Bảng
userslưu thông tin người dùng. - Bảng
orderslưu thông tin chung của từng đơn hàng, chẳng hạn người đặt hàng và ngày tạo đơn. - Bảng
productslưu thông tin sản phẩm như tên, giá bán và số lượng tồn kho. - Bảng
order_itemslưu các sản phẩm thuộc từng đơn hàng, bao gồm số lượng và giá tại thời điểm đặt hàng.
Trong thiết kế này, users và orders có quan hệ One-to-Many vì một người dùng có thể tạo nhiều đơn hàng. orders và products có quan hệ Many-to-Many về mặt nghiệp vụ vì một đơn hàng có thể chứa nhiều sản phẩm và một sản phẩm có thể xuất hiện trong nhiều đơn hàng. Quan hệ này được triển khai thông qua bảng trung gian order_items.
Bảng trung gian không chỉ chứa khóa ngoại mà còn lưu được những thông tin riêng của từng dòng đơn hàng, chẳng hạn số lượng sản phẩm và đơn giá tại thời điểm mua. Điều này rất quan trọng vì giá sản phẩm có thể thay đổi sau khi đơn hàng đã được tạo.
Cách thiết kế này giúp tránh việc phải tạo các cột cố định như product_1, product_2 hay product_3 trong bảng đơn hàng. Khi số lượng sản phẩm tăng lên, hệ thống vẫn có thể lưu trữ dữ liệu mà không cần thay đổi cấu trúc bảng mỗi lần.
6. Normalization – Chuẩn hóa cơ sở dữ liệu
Normalization (chuẩn hóa cơ sở dữ liệu) là quá trình tổ chức dữ liệu nhằm giảm sự trùng lặp và hạn chế những vấn đề phát sinh khi thêm, sửa hoặc xóa dữ liệu.
Ví dụ, nếu mỗi đơn hàng đều lưu lại tên, email và địa chỉ của người dùng trong cùng một bảng, những thông tin này sẽ bị lặp lại nhiều lần. Khi người dùng thay đổi email, hệ thống có thể phải cập nhật nhiều bản ghi, dễ dẫn đến tình trạng dữ liệu không đồng nhất.
Thay vào đó, thông tin người dùng có thể được lưu trong bảng users, còn bảng orders tham chiếu đến người dùng thông qua khóa ngoại. Cách tổ chức này giúp hạn chế lặp dữ liệu và dễ quản lý hơn.
Một số mức chuẩn hóa thường được nhắc đến là 1NF, 2NF và 3NF. Ở mức cơ bản, 1NF yêu cầu mỗi trường chứa một giá trị đơn theo mô hình quan hệ thông thường; 2NF xử lý sự phụ thuộc không đầy đủ vào khóa chính trong những trường hợp có khóa ghép; còn 3NF hướng đến việc loại bỏ những phụ thuộc bắc cầu không phù hợp giữa các thuộc tính không khóa.
Tuy nhiên, chuẩn hóa không có nghĩa là phải tách mọi dữ liệu thành thật nhiều bảng. Việc thiết kế cần cân bằng giữa tính toàn vẹn, khả năng bảo trì và hiệu suất truy vấn. Trong một số trường hợp, hệ thống có thể chủ động lưu trùng một phần dữ liệu để đáp ứng yêu cầu hiệu năng hoặc lưu lại lịch sử giao dịch.
7. Index và những lưu ý khi thiết kế cơ sở dữ liệu
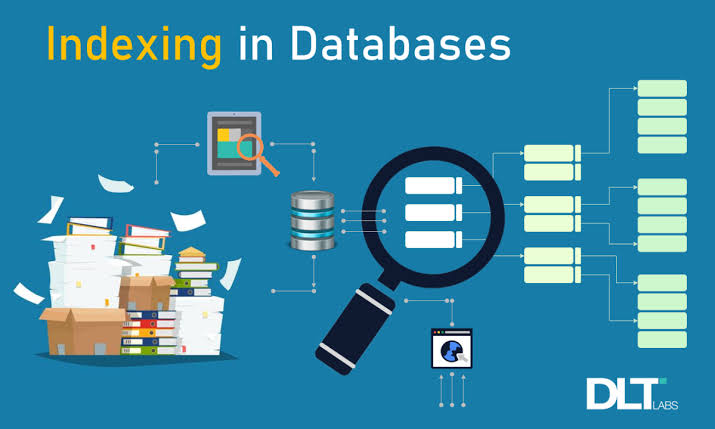
Index (chỉ mục) là cấu trúc hỗ trợ cơ sở dữ liệu tìm kiếm bản ghi nhanh hơn trong nhiều trường hợp. Có thể hình dung index giống như mục lục của một cuốn sách: thay vì phải đọc toàn bộ nội dung, hệ thống có thể sử dụng chỉ mục để tìm đến dữ liệu cần thiết hiệu quả hơn.
Ví dụ, nếu website thường xuyên tìm người dùng theo email, việc tạo index trên cột email có thể cải thiện hiệu suất truy vấn. Tuy nhiên, index cũng chiếm thêm dung lượng và làm tăng chi phí khi thêm, sửa hoặc xóa dữ liệu, vì vậy không nên tạo chỉ mục một cách tùy tiện.
Ngoài index, khi thiết kế cơ sở dữ liệu cần chú ý đến một số vấn đề sau:
- Đặt tên bảng và cột rõ ràng, thống nhất.
- Chọn kiểu dữ liệu phù hợp với thông tin cần lưu.
- Xác định khóa chính và khóa ngoại chính xác.
- Sử dụng các ràng buộc như NOT NULL, UNIQUE và CHECK khi phù hợp.
- Xác định cách xử lý khi dữ liệu được tham chiếu bị xóa hoặc cập nhật.
- Hạn chế lưu dữ liệu trùng lặp không cần thiết.
- Xem xét các truy vấn thường xuyên sử dụng để thiết kế index hợp lý.
Một cơ sở dữ liệu tốt không chỉ cần lưu được dữ liệu mà còn phải bảo đảm dữ liệu chính xác, dễ truy vấn, an toàn và có thể mở rộng khi ứng dụng phát triển.
8. Kết luận
Database Design & Relationships là kiến thức nền tảng trong phát triển backend, giúp lập trình viên tổ chức dữ liệu và xác định mối liên hệ giữa các đối tượng trong hệ thống. Thiết kế cơ sở dữ liệu không chỉ bao gồm việc tạo bảng mà còn cần xác định kiểu dữ liệu, khóa chính, khóa ngoại, các loại quan hệ và quy tắc bảo đảm tính toàn vẹn.
Qua quá trình tìm hiểu, mình hiểu rằng việc thiết kế cơ sở dữ liệu cần bắt đầu từ nghiệp vụ thực tế của ứng dụng. Khi xác định đúng các đối tượng và mối quan hệ giữa chúng, lập trình viên có thể hạn chế dữ liệu trùng lặp, giảm lỗi khi cập nhật và giúp hệ thống dễ bảo trì hơn.
Đây là kiến thức quan trọng khi làm việc với PostgreSQL, MySQL hoặc các hệ quản trị cơ sở dữ liệu quan hệ khác, đặc biệt trong những dự án có nhiều loại dữ liệu và các nghiệp vụ liên quan với nhau.

Bài viết khác
Test Automation(Kiểm thử tự động)
1.Test Automation (Kiểm thử tự động) là gì? Trong các dự án phát triển phần mềm truyền thống trước đây, toàn bộ quy trình kiểm thử (Testing) đều được thực hiện thủ công (Manual Testing) bởi con người. Các kiểm thử viên trực tiếp thao tác trên giao diện, nhập dữ liệu, kiểm tra kết […]
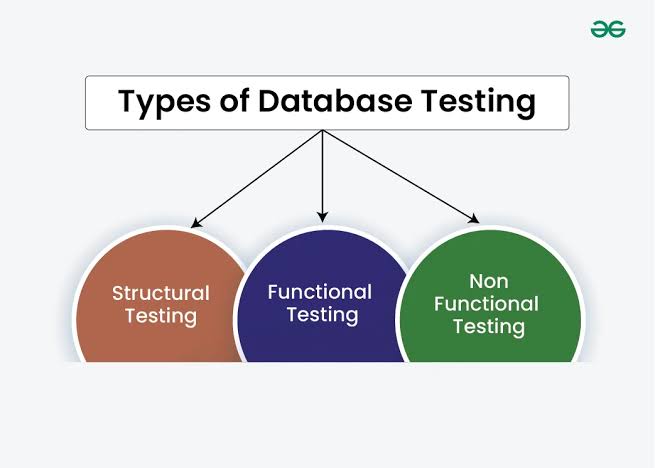
SQL / Database Testing(Kiểm thử cơ sở dữ liệu)
1.SQL / Database Testing là gì? Trong các hệ thống phần mềm doanh nghiệp đa tầng (Multi-tier Enterprise Systems), giao diện người dùng (Frontend) đóng vai trò là lớp vỏ tương tác ngoại quan, tầng dịch vụ (Backend/API) giữ nhiệm vụ điều phối và xử lý các quy tắc nghiệp vụ, nhưng nơi thực sự […]
Postman
1.Postman là gì? Trong quá trình phát triển và kiểm thử phần mềm hiện đại, khi kiến trúc hệ thống dịch chuyển mạnh mẽ sang mô hình dịch vụ vi mô (Microservices) và các ứng dụng đa nền tảng, việc kiểm thử tầng dịch vụ API (API Testing) trở thành công việc thường nhật của […]
API Testing(Kiểm thử API)
1.API Testing (Kiểm thử API) là gì? Trong các hệ thống phần mềm doanh nghiệp truyền thống trước đây (kiến trúc Monolithic), ứng dụng thường được xây dựng thành một khối thống nhất gồm giao diện người dùng (Frontend) gắn liền trực tiếp với tầng xử lý logic và cơ sở dữ liệu (Backend). Tuy […]
Database Indexes
1. Database Indexes là gì? Database Indexes (chỉ mục cơ sở dữ liệu) là một cơ chế được sử dụng để tăng tốc độ tìm kiếm và truy xuất dữ liệu trong database. Theo mình tìm hiểu, có thể hiểu Index giống như mục lục ở cuối một quyển sách. Thay vì phải đọc từng […]
Transactions and ACID
1. Transaction là gì? Transaction (giao dịch) trong cơ sở dữ liệu là một nhóm thao tác được thực hiện như một đơn vị công việc. Những thao tác này thường liên quan đến việc thêm, sửa hoặc xóa dữ liệu và cần được quản lý để bảo đảm dữ liệu không rơi vào trạng […]
 Khoá học lập trình game con rắn cho trẻ em